Програма · Performance Engineering

Набір скоро відкриється

Performance Testing with k6

QA / AQA / DevOps → Performance Engineer

Практичний курс для DevOps та QA: пишіть load tests в k6, будуйте dashboards в Grafana, інтегруйте performance testing в CI/CD та Kubernetes — і перевіряйте стійкість системи через chaos-тестування.

  • Занять15
  • Тривалість15 тижнів
  • РівеньMiddle–Senior
  • Група8–12 осіб
  1. Middle
  2. Senior

01. Для кого

Дві ситуації, з якими
приходять на Performance Testing with k6

QA-інженери (middle/senior)

«Я вмію тестувати функціонал, але коли мене питають „а як воно поводиться під навантаженням“ — я губляюсь і не знаю, з чого почати»

Навчитеся

Навчитеся формулювати NFR, писати й підтримувати k6-тести, читати метрики (InfluxQL/PromQL), будувати dashboards Grafana та знаходити регресії performance до release.
DevOps-інженери (middle/senior)

«У нас є CI/CD і моніторинг, але performance tests хтось запускає вручну раз на квартал — хочу, щоб це працювало автоматично і давало зрозумілий результат»

Навчитеся

Збудуєте observability-стек (k6 → storage → Grafana), вбудуєте k6 у CI/CD як gate, запустите розподілені тести в Kubernetes через k6-operator і додасте AI-аналіз та chaos-експерименти.

02. Результат

Сім речей, які ви
зможете робити після курсу

  1. 01Формулювати NFR і будувати процес performance testing на проєкті
  2. 02Писати якісні load tests в k6, включно з AI-генерацією
  3. 03Глибоко аналізувати метрики через InfluxDB (InfluxQL) та Prometheus (PromQL)
  4. 04Будувати dashboards в Grafana, включно з порівнянням run-to-run
  5. 05Тестувати UI performance через k6 browser та вимірювати Web Vitals
  6. 06Інтегрувати k6 в CI/CD та запускати розподілені тести в Kubernetes (k6-operator)
  7. 07Підключати AI-агента для аналізу результатів і робити Chaos Testing з xk6-disruptor

03. Програма курсу

4 модулі Performance Testing with k6

15 занять · Практичні завдання · Фінальний проєкт

Курс іде від процесу і NFR до observability, CI/CD, Kubernetes та chaos-тестування: теорія, практика на занятті і домашнє завдання на кожну тему.

1 Основи процесу performance testing заняття 1 · базовий рівень Модуль 1
  1. Заняття 1

    NFR та побудова процесу performance testing на проєкті

    Розглянемо, що таке non-functional requirements (NFR): response time, throughput, error rate, scalability, availability, та як їх правильно формулювати разом із бізнесом і розробниками. Поговоримо, як вписати performance testing у процес розробки — коли і як часто запускати тести, хто відповідає за результати, як визначити baseline та критерії "пройшов/не пройшов". Окремо торкнемося ролі моніторингу як частини процесу: що моніторити постійно, а що перевіряти точково через load tests.

    Практика: на прикладі тестового проєкту визначаємо NFR для двох-трьох ключових сценаріїв (наприклад, логін, пошук, оформлення замовлення) та накидаємо схему процесу — хто, коли, як часто запускає тести і куди йдуть результати.

    ДЗ: для свого (або наданого) проєкту сформулювати NFR для 3–5 ключових сценаріїв та описати процес performance testing на проєкті (етапи, відповідальні, частота, критерії прийняття). Здати: документ з таблицею NFR (сценарій / метрика / цільове значення / критичне значення) + текстовий опис або схема процесу.

2 k6 — написання тестів, dashboards та AI-генерація заняття 2–4 · середній рівень Модуль 2
  1. Заняття 2

    Writing Tests, Key Metrics

    Розглянемо, як писати якісні load tests в k6: структура тесту (default function, setup/teardown), virtual users, stages та executors (constant-vus, ramping-vus, constant-arrival-rate тощо), checks і thresholds. Розберемо ключові метрики, які варто відстежувати завжди: http_req_duration (та його під-метрики), http_req_failed, vus/vus_max, iterations, data_sent/data_received, та що означає кожна з них у summary-звіті k6.

    Практика: пишемо k6-тест для наданого API (кілька ендпоінтів, checks, thresholds на response time та error rate), запускаємо тест через CLI та аналізуємо summary-звіт.

    ДЗ: написати k6-тест для заданого сценарію (мінімум 3 ендпоінти, checks, thresholds на response time та error rate). Здати: файл k6-скрипта, скріншот/вивід summary з результатами запуску, короткий звіт — чому обрані саме такі thresholds і що показали отримані метрики.

  2. Заняття 3

    Default Dashboard (k6 dashboard extension та Grafana)

    Розглянемо два варіанти стандартної візуалізації результатів k6 без написання власних dashboards: вбудоване розширення k6 dashboard (web dashboard у реальному часі під час запуску, --out web-dashboard/HTML-звіт) та стандартний Grafana dashboard для k6 (на базі InfluxDB або Prometheus). Розберемо по панелях, що показує кожен з них: request rate, response time percentiles, error rate, VUs over time тощо, та коли який варіант доцільніше використовувати.

    Практика: запускаємо тест із заняття 2 з увімкненим k6 dashboard extension, а потім — з виводом у Grafana через стандартний dashboard, порівнюємо обидва представлення.

    ДЗ: запустити тест із заняття 2 двома способами — з k6 dashboard extension та зі стандартним Grafana dashboard, зробити скріншоти. Здати: скріншоти обох dashboards, письмова інтерпретація — що показує кожна панель та які значення отримані для цього тесту, у чому переваги/обмеження кожного варіанта.

  3. Заняття 4

    AI-Powered Test Generation

    Розглянемо, як використовувати AI-інструменти для автогенерації k6-скриптів на основі специфікації API (OpenAPI/Swagger) або запису трафіку (HAR-файл). Поговоримо про стратегії промптингу для отримання якіснішого результату, типові помилки, які робить AI (неправильні checks, відсутні thresholds, хардкод даних), та як критично переглядати й доопрацьовувати згенерований код перед використанням у реальному проєкті.

    Практика: беремо специфікацію API або HAR-файл, генеруємо k6-скрипт за допомогою AI-інструменту, переглядаємо та виправляємо знайдені проблеми.

    ДЗ: згенерувати за допомогою AI k6-тест для заданого сценарію (на основі специфікації API або HAR-файлу), доопрацювати та довести скрипт до робочого стану. Здати: оригінальний AI-згенерований скрипт, фінальний доопрацьований скрипт, короткий звіт (які помилки/недоліки були в згенерованому коді, що довелось виправити вручну).

3 Observability та метрики: InfluxDB, Prometheus, Grafana заняття 5–9 · середній рівень Модуль 3
  1. Заняття 5

    Концепція Observability: ключові метрики та компоненти

    Розглянемо архітектуру observability-стеку для performance testing як ланцюжок: producer (k6, що генерує метрики) → collector/receiver → metric storage → visualization. Поговоримо про push vs pull моделі збору метрик, роль кожного компонента в системі, та зробимо огляд варіантів, які розглянемо в наступних заняттях — InfluxDB та Prometheus як storage, Grafana як visualization layer.

    Практика: малюємо схему observability-архітектури для стенду для performance testing та позначаємо, де в ній знаходиться k6, storage та Grafana, обговорюємо альтернативні конфігурації.

    ДЗ: для свого проєкту описати, яку observability-архітектуру для performance tests планується використовувати (який storage, як k6 надсилає дані, де візуалізація) та обґрунтувати вибір. Здати: схема/діаграма архітектури (producer → collector → storage → visualization) + текстове обґрунтування вибору компонентів.

  2. Заняття 6

    InfluxDB як metric storage та InfluxQL

    Розглянемо модель даних InfluxDB: measurements, tags, fields, timestamps, та як k6 записує результати тестів у InfluxDB (вбудований output k6). Розберемо основи InfluxQL: SELECT-запити, GROUP BY time(), агрегаційні функції (mean, percentile, count), фільтрацію за tags.

    Практика: надсилаємо результати k6-тесту в InfluxDB та пишемо InfluxQL-запити для вибірки середнього та p95 response time, згрупованих за часом та ендпоінтом.

    ДЗ: запустити k6-тест з виводом у InfluxDB та написати 3–5 InfluxQL-запитів, що відповідають на конкретні питання (наприклад: p95 response time по кожному ендпоінту за часом, тренд error rate протягом тесту). Здати: список запитів з результатами (скріншоти/вивід), короткий опис, що показує кожен запит.

  3. Заняття 7

    Prometheus як metric storage та PromQL

    Розглянемо модель даних Prometheus: metrics, labels, time series, відмінність pull-моделі Prometheus від push-моделі InfluxDB та як k6 надсилає дані в Prometheus (remote write). Розберемо основи PromQL: rate(), агрегаційні функції, та особливо histogram_quantile() для обчислення перцентилів з histogram-метрик.

    Практика: налаштовуємо k6 на відправку метрик у Prometheus через remote write та пишемо PromQL-запити для error rate (через rate()) та p95 response time (через histogram_quantile()).

    ДЗ: налаштувати k6 на надсилання метрик у Prometheus та написати 3–5 PromQL-запитів, серед яких обов'язково мінімум один з histogram_quantile(). Здати: запити з результатами/скріншотами, короткий опис, що показує кожен запит та чим він відрізняється від аналогічного InfluxQL-запиту з минулого заняття.

  4. Заняття 8

    Grafana як основний opensource visualization tool та інтеграція з Influx і Prometheus

    Розглянемо архітектуру Grafana: data sources, dashboards, panels, variables. Навчимось підключати одночасно InfluxDB та Prometheus як джерела даних в одній Grafana-інсталяції та будувати панелі на основі запитів, написаних у заняттях 6 та 7.

    Практика: підключаємо InfluxDB та Prometheus як data sources в Grafana, будуємо dashboard з панелями на базі обох джерел та додаємо змінну (variable) для фільтрації за ендпоінтом/тестовим запуском.

    ДЗ: побудувати Grafana dashboard з мінімум 4 панелями — 2 на основі InfluxQL-запитів та 2 на основі PromQL-запитів з попередніх занять, додати variables для фільтрації. Здати: експорт dashboard (JSON) або скріншоти, опис кожної панелі та запиту, що в ній використано.

  5. Заняття 9

    k6: відправка метрик з tags, groups та fields для Influx і Prometheus + load-профілі

    Розглянемо, як використовувати tags та groups у k6 для деталізації результатів — як вони мапляться на tags/fields у InfluxDB та на labels у Prometheus. Розберемо custom-метрики k6 (Trend, Counter, Gauge, Rate) та як їх можна аналізувати в обох storage. Окремо створимо власний load-профіль (ramp-up → steady state → spike → ramp-down) за допомогою executors, що імітує реальну поведінку користувачів, і протегуємо сценарії для подальшої фільтрації в dashboards.

    Практика: додаємо tags/groups та custom-метрику до існуючого тесту, будуємо багатоетапний load-профіль, надсилаємо результати одночасно в InfluxDB та Prometheus, оновлюємо Grafana-панелі з фільтрацією за тегами.

    ДЗ: доопрацювати тест з попередніх занять — додати tags/groups, мінімум одну custom-метрику та власний load-профіль (мінімум 3 етапи навантаження), надіслати результати в InfluxDB і Prometheus, оновити Grafana-dashboard з панелями, що фільтруються/групуються за тегами. Здати: k6-скрипт з tags/groups/custom-метриками та конфігурацією load-профілю, оновлений dashboard (експорт/скріншоти), короткий звіт з інтерпретацією результатів.

4 Просунуте performance testing та DevOps-інтеграція заняття 10–15 · просунутий Модуль 4
  1. Заняття 10

    UI Performance Testing за допомогою k6 browser-тестів

    Розглянемо модуль k6 browser та чим він відрізняється від протокольних тестів — коли потрібно тестувати саме UI performance, а не тільки backend. Розберемо ключові метрики Web Vitals (LCP, FCP, CLS, TTI) та як їх вимірювати через k6 browser. Поговоримо про комбіновані сценарії, де частина VU генерує фонове навантаження на API, а інша — відкриває сторінки в браузері та вимірює UI-метрики.

    Практика: пишемо k6 browser-тест для заданої сторінки, який відкриває сторінку, виконує дії користувача (клік, скрол, заповнення форми) та збирає метрики Web Vitals.

    ДЗ: написати k6 browser-тест для 1–2 ключових сторінок проєкту, що вимірює Web Vitals під фоновим навантаженням на API (комбінований сценарій). Здати: k6-скрипт (browser + протокольна частина), звіт зі значеннями Web Vitals до/під навантаженням, висновки щодо UI performance.

  2. Заняття 11

    Побудова dashboard для порівняння результатів між запусками

    Навчимось будувати в Grafana dashboards, які дозволяють порівнювати результати кількох запусків тестів (baseline vs поточний, release vs release). Розберемо роботу з тегами/annotations у k6, змінними (variables) у Grafana та способи візуалізації трендів у часі — щоб легко помічати регресії, покращення та довгострокові тенденції.

    Практика: налаштовуємо теги для запусків k6, будуємо в Grafana dashboard з variable для вибору запуску та порівнюємо два запуски за основними метриками.

    ДЗ: запустити один і той же тест мінімум 2–3 рази (з різними версіями коду/конфігурації) та побудувати порівняльний dashboard у Grafana, що показує зміну метрик між запусками. Здати: експорт/скріншоти порівняльного dashboard, короткий звіт — чи є регресія, за якими метриками, можливі причини.

  3. Заняття 12

    CI/CD інтеграція

    Покроково розберемо, як інтегрувати k6-тести в CI/CD pipeline (GitHub Actions, GitLab CI або інший інструмент за домовленістю). Поговоримо про стратегії запуску: smoke performance tests на кожен PR, повноцінні тести на staging перед release, thresholds як критерій pass/fail для pipeline, а також про публікацію результатів (артефакти, звіти, нотифікації в Slack/Teams).

    Практика: налаштовуємо pipeline, який запускає k6-тест з thresholds і завалює білд, якщо performance не відповідає вимогам.

    ДЗ: інтегрувати раніше написаний k6-тест у CI/CD pipeline з thresholds, налаштувати збереження результатів як артефактів та (опційно) нотифікацію про результат. Здати: конфігураційний файл pipeline, скріншоти/логи успішного та проваленого запусків (наприклад, штучно занижений threshold).

  4. Заняття 13

    Запуск k6-тестів у Kubernetes з k6-operator

    Розглянемо, як деплоїти та запускати k6-тести всередині Kubernetes-кластера за допомогою k6-operator. Поговоримо про best practices: розподіл навантаження між кількома подами (distributed execution), управління ресурсами (requests/limits), вибір кількості та розміру воркерів залежно від цільового навантаження, а також про збір метрик з розподілених тестів у централізований Grafana dashboard.

    Практика: встановлюємо k6-operator у тестовий кластер (kind/minikube), створюємо TestRun-маніфест та запускаємо розподілений тест на декілька подів.

    ДЗ: розгорнути k6-operator у власному/тестовому кластері, налаштувати TestRun для запуску раніше написаного тесту в розподіленому режимі (мінімум 2 воркери) з відправкою метрик у Prometheus/InfluxDB. Здати: файли маніфестів (operator config, TestRun), скріншоти логів/подів під час запуску, скріншот dashboard з агрегованими метриками.

  5. Заняття 14

    AI-агент з Grafana MSP та API для аналізу результатів k6-тестів

    Розглянемо, як підключити AI-агента до можливостей машинного навчання/статистичного аналізу (MSP) у Grafana для автоматичного аналізу результатів k6-тестів. Поговоримо про автоматичне виявлення аномалій (anomaly detection), порівняння з історичними даними та генерацію зрозумілих текстових висновків для команди — без необхідності вручну переглядати кожен dashboard після кожного запуску.

    Практика: підключаємо AI-агента до Grafana-dashboard з результатами одного з попередніх запусків та отримуємо автоматичний звіт з виявленими аномаліями.

    ДЗ: налаштувати AI-агента для аналізу результатів одного з раніше виконаних тестових запусків (за вибором — порівняльний dashboard із заняття 11 або dashboard з Kubernetes-запуску із заняття 13), зафіксувати, які аномалії/висновки агент виявив. Здати: опис налаштування інтеграції, згенерований AI-звіт, коментар студента — чи погоджується він з висновками агента і чому.

  6. Заняття 15

    Chaos Testing разом з xk6-disruptor

    Розглянемо основи chaos engineering у контексті performance testing: чому важливо перевіряти не лише поведінку системи під навантаженням, а й її стійкість до збоїв під навантаженням одночасно. Розберемо розширення xk6-disruptor та як воно інтегрується з k6-тестами: внесення мережевих затримок та помилок (HTTP/gRPC faults), збої на рівні Pod у Kubernetes (pod disruptor), обмеження ресурсів. Поговоримо, як комбінувати load-тест з контрольованим chaos-експериментом та інтерпретувати вплив на метрики (response time, error rate) під час та після збою.

    Практика: запускаємо k6-тест з фоновим навантаженням та одночасно вносимо HTTP-фолт (наприклад, затримку або помилку) за допомогою xk6-disruptor, спостерігаємо за зміною метрик у Grafana в реальному часі.

    ДЗ: спроєктувати та провести chaos-експеримент — комбінацію load-тесту з xk6-disruptor (наприклад, pod disruptor для сервісу в Kubernetes або HTTP fault для конкретного ендпоінта), зафіксувати поведінку системи до, під час та після збою. Здати: k6-скрипт/конфігурація з xk6-disruptor, скріншоти dashboard "до/під час/після" збою, звіт з висновками про стійкість системи та рекомендаціями.

04. Фінальний проєкт

Project

Ви проходите повний цикл performance testing з реальним стеком і здаєте:

github.com/you/k6-performance-testing-project
  • NFR та процесдокумент з NFR для 3–5 сценаріїв + опис процесу performance testing
  • Протокольні k6-тестимінімум 3 сценарії з checks і thresholds (частково AI-генеровані)
  • Browser-тест(и)k6 browser-тест з вимірюванням Web Vitals
  • Observability-стекcustom load-профіль, tags/groups, метрики в InfluxDB та Prometheus
  • Dashboardsстандартний + кастомний + порівняльний (run-to-run)
  • CI/CD pipelinek6-тести з thresholds як gate
  • Kubernetes-запускTestRun через k6-operator
  • AI-аналіззвіт від AI-агента (Grafana MSP)
  • Chaos-експериментload-тест + xk6-disruptor, звіт про стійкість системи

05. Як проходить навчання

Формат, у якому
доводять до результату

  • Практика на кожному заняттіТеорія, практика на занятті та домашнє завдання на кожну тему.
  • Зворотний зв’язокПеревірка домашніх завдань і зворотний зв’язок від ментора.
  • Готовий стекk6, Grafana, Prometheus та k8s-маніфести — усе, що потрібно для фінального проєкту.

Стек курсу

Тільки те, що працює у production — без «оглядових» інструментів

Load testing

  • k6
  • k6 browser
  • xk6-disruptor

Observability

  • InfluxDB
  • Prometheus
  • Grafana

Інфраструктура

  • CI/CD
  • Kubernetes
  • k6-operator

AI

  • AI-агент (Grafana MSP)
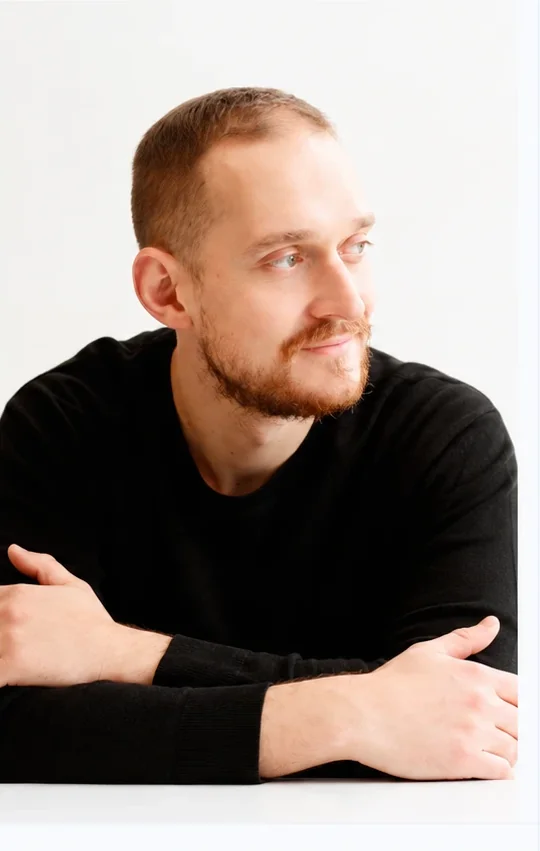
Єгор Максимчук — засновник і викладач QAStudy.online

06. Викладач

Автор програми
і лектор — Єгор Максимчук

QA & Performance Architect · AI Agent Development & Testing · 14+ років в IT

  • 14+років в IT
  • 22scrum teams у зоні відповідальності
  • 6доменів — від fintech до держсектору
  • US fintechPerformance Architect зараз
  • GitHub Copilot
  • Microsoft Certified: Azure Fundamentals (AZ-900)
  • ICAgile Certified Professional — Agile Project & Delivery Management (ICP-APM)
  • Certificate Architect — Professional
  • Certificate Architect — Foundations
  • Certificate Associate — Foundations
  • Certificate Developer — Foundations
  • GitHub Certified: Agentic AI Developer

07. Вартість

Скільки коштує
наступний рівень

Повна вартість

33 000 грн

Повна вартість програми: 15 занять по 2–3 години практики з ментором, перевірка ДЗ та зворотний зв’язок, готовий стек технологій.

Що входить

  • 15 занять із практикою з ментором на кожному занятті
  • Перевірка домашніх завдань і зворотний зв’язок
  • Готовий стек технологій: k6, Grafana, Prometheus, k8s-маніфести
  • Фінальний проєкт з реальним стеком для performance testing
Повідомити про старт

Чому курс окупається

Performance Engineer та SDET — серед позицій з найвищими зарплатами в тестуванні, що часто прирівнюються до Senior-розробника. За даними зимового зарплатного звіту DOU 2026, медіанна зарплата DevOps/SRE — $4200, QA Tech Lead — $4600. Курс готує саме до переходу в ці напрямки.

Джерела: DOU, зарплатний звіт QA, зима 2026